Практическое задание · application

Собственный LLM-wrapper

Условие

Зачем нужен

LLM-wrapper превращает прямой вызов модели в управляемую часть приложения: определяет тип запроса, собирает нужный контекст, применяет подходящий промпт и проверяет структуру результата. Он нужен, когда одного вызова model.generate() уже недостаточно, но автономный агент ещё не требуется.

Где применяется

  • корпоративные помощники и чат-боты с несколькими сценариями;
  • генерация структурированных данных для API и бизнес-процессов;
  • обработка обращений, документов и внутренних запросов;
  • единая точка для timeout, retry, логирования и выбора модели.

Задача

Разработать LLM-wrapper для выбранного сценария.

Обязательные требования

  • классификация пользовательских запросов по intent;
  • поддержка контекста диалога;
  • шаблонизация промптов;
  • структурированный ответ с Pydantic-валидацией.

Расширение

Добавить новые intents и научиться определять несколько намерений в одном запросе.

Ожидаемый результат

Приложение принимает запрос, классифицирует его, формирует промпт с учётом истории и возвращает валидированный объект.
Моё решение

Архитектура

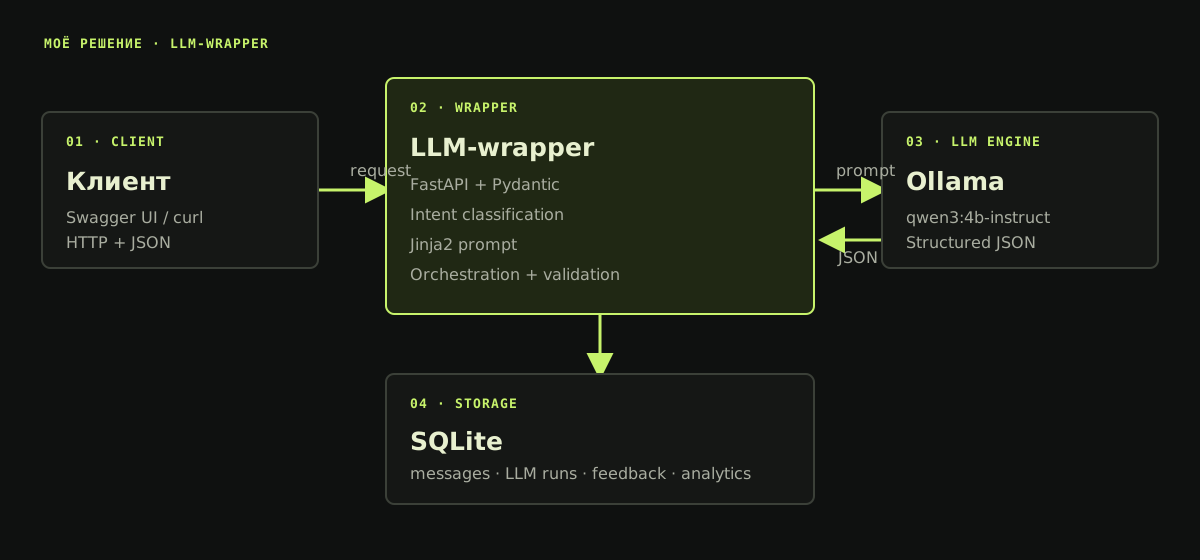
Клиентом выступает Swagger UI или curl. Он вызывает FastAPI endpoints и передаёт JSON. Wrapper валидирует запрос, определяет intent и управляет вызовами локальной модели.

Репозиторий решения: smaginen/llm-wrapper-ollama

Архитектура решения: клиент, LLM-wrapper, Ollama и SQLite

Компоненты

  • Клиент: Swagger UI или curl, вызывающий HTTP endpoints.
  • Wrapper: FastAPI, Pydantic, Jinja2, intent classification и orchestration.
  • LLM engine: локальная Ollama с моделью qwen3:4b-instruct.
  • Хранилище: SQLite для диалогов, сообщений, LLM runs, feedback и аналитики.

Functional requirements — реализовано

  • Pydantic проверяет входные данные и форму структурированного ответа.
  • Classifier определяет course_question, practice_help или off_topic.
  • conversation_id связывает сообщения одной сессии, а сервер восстанавливает историю из SQLite.
  • Каждый вызов LLM сохраняет этап, модель, temperature, latency, статус и тип ошибки.
  • Пользователь может оценить ответ от 1 до 5 и оставить комментарий.
  • Analytics endpoints показывают объём диалогов, intents, ошибки, latency и feedback.

Non-functional requirements — реализовано

  • Timeout: время ожидания Ollama задаётся через environment.
  • Bounded context: wrapper ограничивает историю последними сообщениями.
  • Observability: LLM runs и ошибки доступны для последующей аналитики.
  • Privacy: модель и SQLite работают локально, без отправки диалогов во внешний API.
  • Testability: unit- и HTTP-тесты используют fake LLM и временную базу.
  • Graceful errors: сетевые ошибки и невалидный ответ модели превращаются в контролируемые HTTP 502/503.

Non-functional requirements — следующий этап

  • Retry: повторять только временные ошибки с exponential backoff и jitter.
  • Fallback: переключаться на резервную модель при недоступности или невалидном ответе основной.
  • Idempotency: не создавать дубли сообщений при повторе HTTP-запроса.
  • Data lifecycle: определить retention, удаление диалогов, резервное копирование и миграции схемы.
  • Cost and usage: сохранять токены и скорость генерации, если LLM engine возвращает эти метрики.
Ретроспектива

RAG этому решению пока не нужен. Он потребуется, когда ответ нужно будет обосновывать внешними документами. История и аналитика решаются обычным хранилищем.